Блог → Инструкции
Что такое LLM: большая языковая модель простыми словами
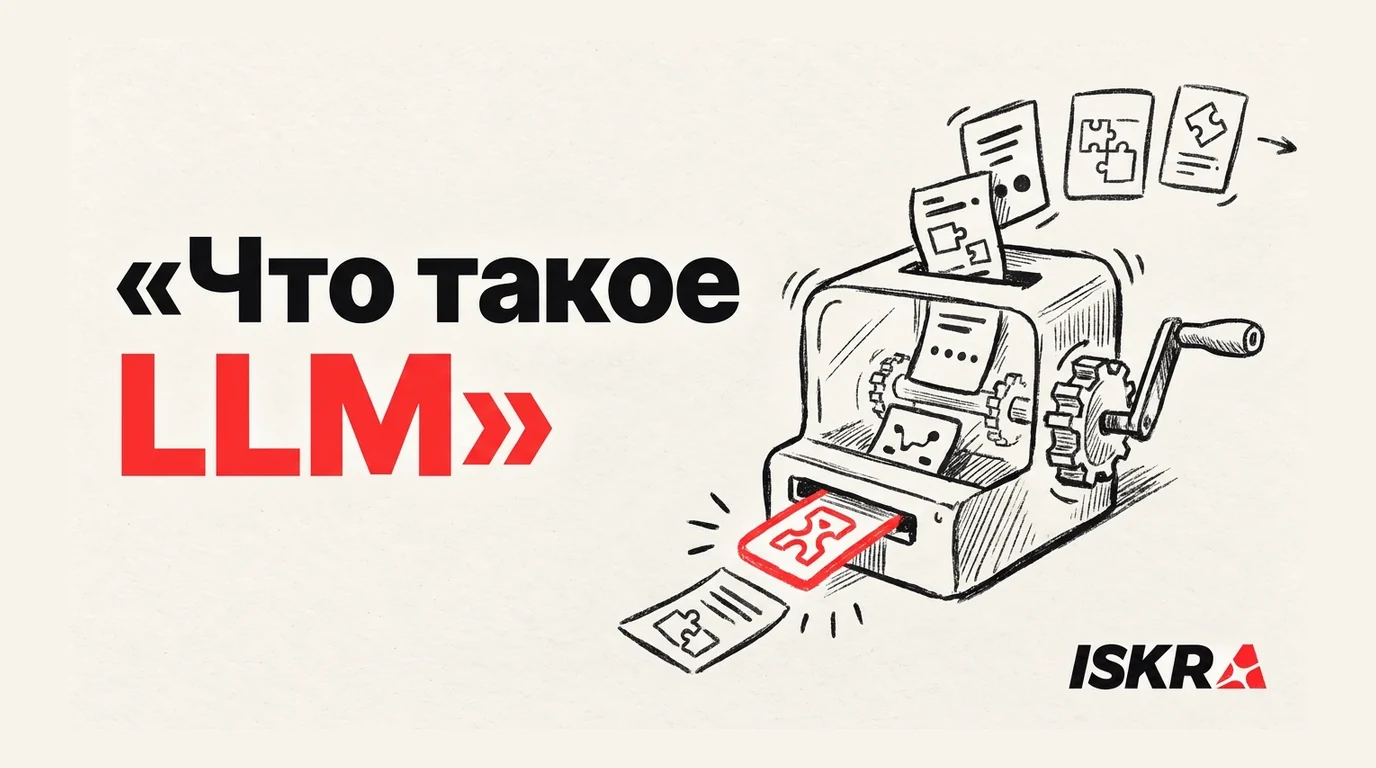
LLM — это большая языковая модель: нейросеть, которая не достаёт готовый ответ из базы, а каждый раз достраивает текст, выбирая следующий фрагмент по вероятности.
Вы открываете чат, пишете «напиши оффер» и получаете абзац текста. За этим абзацем стоит LLM — Large Language Model, большая языковая модель.
Ниже — рабочее определение и граница, за которой модель перестаёт быть полезным инструментом и начинает быть источником ошибок в отчёте.
LLM простыми словами
LLM (Large Language Model, большая языковая модель) — нейросеть, обученная на очень большом объёме текста. На входе у неё фрагмент, на выходе — продолжение: слово за словом, точнее токен за токеном.
Три части названия работают отдельно:
- Большая: много обучающих данных и много параметров — внутренних чисел, которые модель подстроила в обучении. У современных моделей счёт параметров идёт на миллиарды.
- Языковая: работает с текстом в широком смысле — письма, статьи, код, JSON, разметка.
- Модель: не программа с прописанными правилами грамматики. Закономерности она вытащила из данных, а не из учебника.
LLM не хранит картотеку ответов. Один и тот же вопрос, заданный иначе, даёт другой текст. Поэтому качество результата зависит от формулировки задачи не меньше, чем от «умности» модели.
Чем LLM отличается от ИИ, нейросети и чата
Между ними не всегда будет стоять знак равно, поэтому попробуем разобраться.
| Термин | Что это | Пример |
|---|---|---|
| Искусственный интеллект | Любая система, которая берёт на себя задачу, обычно требующую человека: классификация, прогноз, генерация. | Скоринг лида, распознавание чека, чат. |
| Нейросеть | Один из способов машинного обучения: слои чисел, которые подстраиваются на примерах. | Сеть для картинок и сеть для текста — обе нейросети, задачи разные, но чаще всего имеют в виду LLM вроде ChatGPT. |
| LLM | Крупная нейросеть именно для языка: продолжает последовательность токенов. | YandexGPT, GigaChat, GPT, Claude, Gemini, Llama, DeepSeek. |
| Чат | Интерфейс поверх модели: история диалога, кнопки, лимиты, иногда поиск в интернете. | Алиса, ChatGPT, корпоративный чат в CRM. |
| AI-агент | Модель плюс инструменты и правила: может изучить рекламный кабинет, записать файл, отредактировать документ. | Агент, который может действовать. |
Чат без инструментов только советует. Агент действует в рамках доступа, который ему выдали.
Как LLM собирает ответ
Пользователь отправляет текст. Модель режет его на токены, смотрит на уже накопленный контекст и выбирает следующий токен. Потом повторяет шаг, пока не закроет ответ или не упрётся в лимит.
Токен — не слово
Токен — кусок текста, которому в словаре модели соответствует номер. Это целое слово, часть слова, знак препинания или обрывок кода. Частые английские слова часто умещаются в один токен. Русский текст в типичных токенизаторах дробится мельче: тот же смысл занимает больше токенов, чем английский. Лимиты контекста и счета за API считают в токенах, не в символах и не в «сообщениях».
Внимание и трансформер
Большинство популярных LLM стоит на архитектуре Transformer. Её описали в статье Attention Is All You Need (Vaswani и соавторы, 2017): сеть опирается на механизм внимания и не использует рекуррентные и свёрточные слои как основу. Внимание для каждого токена оценивает, насколько важны остальные токены в доступном тексте, в том числе далеко от текущей позиции.
Отсюда два следствия для практики. Модель видит весь переданный контекст сразу, а не «помнит» начало письма хуже конца только из-за расстояния. И обучение на огромных корпусах стало возможным, потому что вычисления хорошо параллелятся.
Контекстное окно
Контекстное окно — сколько токенов модель держит в одном проходе: ваш запрос, вложенные файлы, предыдущие реплики и уже сгенерированный кусок ответа. Всё, что за окном, для этого шага не существует. Длинный бриф, который не влез, модель не «прочитала частично и додумала». Она его не видела.
Как модель учат
Короткое объяснение из трёх слоёв:
- 1Предобучение. Модель читает огромный корпус и учится предсказывать следующий фрагмент. На этом этапе появляется общий язык: стиль, факты из текстов, код.
- 2Дообучение на инструкциях. Ей показывают пары «задача — хороший ответ», чтобы она следовала просьбе, а не просто продолжала абзац.
- 3Выравнивание. Ответы людей или правила отсекают опасные и бесполезные продолжения. Это меняет, какие продолжения она предпочитает.
Дальше провайдер может дообучить модель на документах компании или подключить поиск по базе. Это уже продукт вокруг LLM, а не свойство «голой» модели.
Какие задачи LLM закрывает в маркетинге
- Черновик: структура статьи, варианты заголовка, пересказ брифа для команды.
- Классификация: разобрать выгрузку запросов на интенты, если критерии заданы явно.
- Сжатие: выжимка из длинного отчёта в пять пунктов с цифрами из исходника.
- Переписывание: тот же смысл другим тоном, если тон описан примерами, а не словом «экспертно».
- Код и разметка: шаблон UTM, формула, JSON — с проверкой человеком перед продом.
Модель не заменяет частотности Wordstat, статусы CRM и решение, какой оффер показывать. Она ускоряет текст и разбор. Цифры кампании по-прежнему берутся из кабинета, а не из генерации.
Где LLM ошибается
- Галлюцинация. Модель достраивает правдоподобный факт, которого не было во входе: несуществующую статистику, чужой кейс, выдуманную функцию продукта.
- Устаревший срез. Знания из предобучения обрываются на дате корпуса. Курс, тариф и интерфейс кабинета без свежего источника модель не знает.
- Чужой контекст. Без цен, ограничений и голоса бренда текст будет обобщённым. Для читателя он выглядит готовым. Для публикации он не годится.
- Чувствительность к формулировке. «Напиши пост» и «напиши пост на 800 знаков для маркетолога из e-commerce» — разные задачи. Вторая ближе к результату, который можно сдать.
Как поставить задачу модели, чтобы черновик можно было использовать
- 1Назовите роль читателя и результат: «статья для блога на тему Х, которая…».
- 2Дайте факты файлом или списком. Запретите добавлять числа, которых нет во входе.
- 3Зафиксируйте объём, тон и запреты: без «гарантии топа», без цен, которых нет в брифе.
- 4Попросите структуру до текста: тезисы, потом абзацы. Так проще выкинуть слабый блок.
- 5Проверьте факты по источникам до публикации. Черновик — не готовая страница.
Коротко
LLM — нейросеть, которая продолжает текст по вероятности следующего токена. Чат — оболочка. Агент — модель с инструментами.
FAQ
LLM и ChatGPT — одно и то же?
Нет. LLM — класс моделей. ChatGPT — продукт: чат поверх конкретных моделей OpenAI, с интерфейсом, лимитами и своими правилами. YandexGPT и GigaChat — другие продукты на своих моделях.
LLM ищет ответ в интернете?
Сама модель — нет. Она генерирует продолжение по весам и по тексту, который вы передали. Поиск подключают отдельно: тогда в контекст попадают фрагменты страниц, и модель пересказывает уже их. Без этого шага свежих данных в ответе нет.
Почему русский запрос «дороже» английского?
Счёт идёт в токенах. Кириллица в распространённых токенизаторах режется на более короткие куски, чем английские слова. Тот же смысл занимает больше токенов, а лимит окна и цена API завязаны на токены.
Можно ли доверить LLM цифры кампании?
Модель охотно дописывает правдоподобный CAC или CTR. Берите метрики из кабинета и CRM, модели отдавайте уже снятые числа — на пересказ и проверку логики, не на «вспомни статистику».
Чем агент отличается от LLM в ежедневной работе?
LLM отвечает текстом. Агент по правилам читает системы и может выполнить шаг: собрать отчёт, подготовить правку, внести изменение в рекламном кабинете.
Если нужен не чат, а рабочий контур «данные → действие», посмотрите, как устроены SEO-агенты ISKRA: семантика, разбор выдачи и черновик страницы остаются проверяемыми шагами, а не одним абзацем из чата.
Похожие статьи
Топ AI-инструментов для маркетолога в 2026 году: SEO, тексты, SMM и анализ конкурентов
Специализированные AI-инструменты для SEO, копирайтинга, SMM и конкурентной разведки: зарубежные сервисы, российские аналоги и сравнительная таблица.

Факторы ранжирования сайта в 2026 году
Что двигает позиции сайта в 2026 году: AI-выдача, Core Web Vitals, контент и E-E-A-T, поведенческие, ссылочные и коммерческие факторы — и как автоматизировать работу с ними.

Не маркетплейсом едины: 5 каналов продаж для селлера, которые работают в 2026 году
5 рабочих каналов продаж для селлера помимо маркетплейсов: свой магазин, Telegram/VK, SEO-блог, контекст и нишевые площадки — и как вести их без команды.